
 Вернуться к статьям
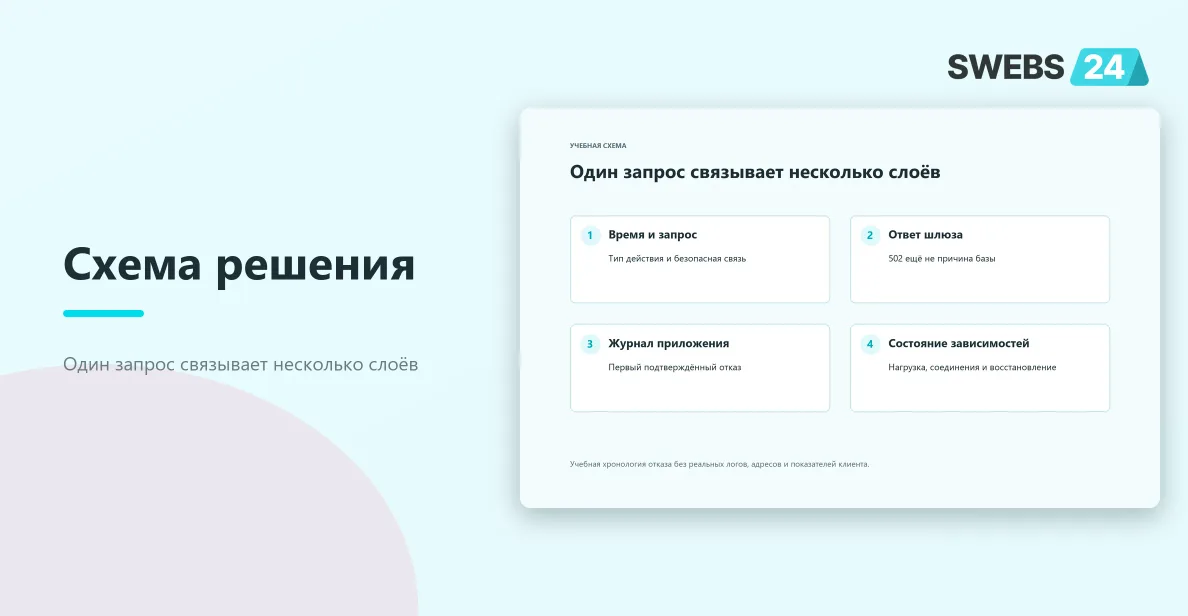
В исходном сообщении сайт иногда медленный, иногда показывает ошибку базы или 502, похожие проблемы есть в админке. Корневая причина не установлена. Ниже дан учебный протокол без настоящих журналов, адресов и серверных показателей клиента. Он помогает разделить слои, но не изображает уже проведённое расследование конкретной системы.
Зафиксировать события отдельно
Запишите время с зоной, тип страницы, действие и фактический статус. «Сайт не работает» слишком широкое описание. Медленное открытие каталога, отказ сохранения в админке и 502 на другом запросе могут иметь общий источник, а могут быть разными событиями. Сначала сохраните их раздельно, чтобы не потерять возможность сравнения.
Проверьте, что ошибка относится к основному документу или вложенному запросу. Страница может открыться, а фоновая загрузка данных отказать. Видимое сообщение базы может быть сформировано приложением с одним HTTP-статусом, а прокси вернуть 502 для другого действия. Снимок экрана показывает проявление, но не всю цепочку.
Не публикуйте полный технический текст ошибки с путями, именами базы и настройками соединения. Для учебного материала достаточно безопасной категории и условного идентификатора запроса. Реальные cookie, токены и клиентские данные в журнале не нужны, чтобы объяснить метод. Минимизация помогает сохранить полезное доказательство без лишнего раскрытия.
| Учебное событие | Наблюдение | Что ещё неизвестно |
|---|---|---|
| Запрос А | Каталог отвечает медленно | Какой этап задержан |
| Запрос Б | Приложение сообщает ошибку данных | Причина зависимости |
| Запрос В | Шлюз возвращает 502 | Что произошло выше по цепочке |
| Запрос Г | Админка снова открылась | Устойчивость восстановления |
Определить, кто сформировал ответ
MDN описывает 502 Bad Gateway как ответ сервера, работающего шлюзом или прокси, при проблеме ответа вышестоящего сервиса. Это отправная точка, а не готовый диагноз. Нужно найти фактический слой: внешний прокси, внутренний веб-сервер или иной компонент. Одинаковый код может появляться при разных состояниях upstream и конфигурации.
Сопоставьте ответ с журналом входного сервера. В Nginx формат журнала настраивается, а контекст записи может соответствовать конечной обработке после внутреннего перенаправления. Не предполагайте, что любая стандартная строка уже содержит все нужные поля. Проверьте реальный формат и доступную связь с приложением, сохраняя ограниченную выборку.
Если приложение не видело запрос, исследование базы по нему преждевременно. Если видело и записало ошибку зависимости, появляется следующий проверяемый участок. Не пропускайте этот переход. Цель состоит в нахождении первого подтверждённого отказа по цепочке, а не в выборе компонента, чьё название видно посетителю.
Согласовать время и связь запросов
Разные процессы могут писать время в разных зонах или с разной точностью. Сначала нормализуйте представление, сохранив исходный контекст. Совпадение минуты слишком слабое основание для связи, когда запросов много. Если архитектура уже передаёт идентификатор запроса или корреляции, используйте его вместо создания отдельной несвязанной системы.
Проверьте, где связь теряется между прокси, приложением и фоновой обработкой. У одного пользовательского действия могут быть несколько запросов. Нельзя считать их одним только по общей странице. Безопасный идентификатор помогает сопоставить события, но его наличие не гарантирует правильную причинную цепочку: нужно понимать, что именно он обозначает.
Для учебной временной шкалы используйте условные Т0, Т1 и Т2. В рабочем расследовании сохраняйте точные отметки и статус каждого участка. Не дорисовывайте недостающую ошибку базы, чтобы заполнить схему. Пробел в наблюдении остаётся пробелом и задаёт конкретный нужный доступ или измерение.
Разобрать ошибку зависимости
Сообщение о базе может означать невозможность соединения, ограничение доступных подключений, долгий запрос, отказ записи или другую категорию. Не объединяйте их в одно «упала база». Найдите безопасную категорию в серверном журнале и сопоставьте с состоянием самой системы данных по разрешённым инструментам. Конкретные команды зависят от используемой СУБД.
Проверьте ожидание соединения отдельно от выполнения запроса, если это видно в телеметрии. Приложение может долго ждать ресурс, а затем быстро выполнить операцию. Узкий таймер SQL не отражает всю задержку. Аналогично отказ прав и исчерпание ресурса требуют разных решений, даже если посетитель видит одинаковую страницу ошибки.
Не выполняйте произвольную «починку базы» и не удаляйте данные на основании общего сообщения. Сначала подтверждение, затем минимальное разрешённое действие. Если нужен доступ администратора СУБД, отметьте конкретный вопрос и период. Остальные слои можно исследовать независимо, не запрашивая все секреты системы и не останавливая подготовку материалов.
Сопоставить ресурсы в том же периоде
Проверьте показатели затронутых процессов и хоста: память, загрузку, диск и другие реальные ограничения. Высокое значение на графике не доказывает причину само по себе. Оно должно соответствовать запросам и механизму отказа. Например, недостаток места и исчерпание соединений относятся к разным ресурсам и требуют разной проверки.
Если приложение работает в контейнере, сравните его ограничения с общим состоянием хоста. Свободная память сервера не означает отсутствие лимита конкретного процесса. Но нельзя объявлять лимит причиной без события или измерения. Сначала установите принадлежность процесса и действующую конфигурацию, не угадывая сервис по знакомому имени.
Периодические задачи и фоновые импорты тоже сопоставляются по времени. Совпадение старта не устанавливает виновника. Нужна связь с ростом нагрузки, блокировкой или подтверждённым отказом. Ограниченный безопасный эксперимент на учебной среде может помочь, но отключение всех задач на рабочем сайте не является обычной диагностической процедурой.
Отличить общий отказ от одной тяжёлой страницы
Выберите несколько типажей и сравните их в одинаковом контексте. Если ошибка появляется только на одном фильтре, исследуйте его путь, не называя проблему общесистемной. Если затронуты публичная часть и админка, ищите подтверждённые общие зависимости. Даже это не доказывает одну причину: разные действия могут одновременно упираться в разные ограничения.
Проверьте холодное и повторное открытие. Кэш способен скрывать отказ приложения на части страниц, пока динамическая операция уже не работает. Поэтому доступная главная не подтверждает здоровье всей системы. Но и медленная первая загрузка после очистки не равна периодической ошибке 502. Сохраняйте различия в протоколе.
Если есть несколько экземпляров приложения или маршрутов, установите, не относится ли сбой к одному из них. Разные версии и настройки могут давать чередование успеха и отказа. Это гипотеза для проверки по разрешённой связи ответа с обработчиком. Не направляйте посетителя к внутреннему узлу и не раскрывайте инфраструктурные адреса в публичном примере.
Проверить полноту наблюдения
Отсутствие строки в журнале не всегда означает отсутствие запроса. Он мог быть отклонён раньше, попасть в другую область записи или ещё находиться в буфере. Документация Nginx описывает настраиваемое и буферизованное журналирование. Сначала проверьте фактическую конфигурацию и границу наблюдения, затем делайте вывод о том, какой слой видел событие.
Не включайте подробный сбор всех параметров на длительное время. Он может увеличить нагрузку и объём файлов, а также сохранить лишние данные. Выберите ограниченный период и категорию, достаточную для гипотезы. После проверки верните штатный режим по разрешённой процедуре, сохранив только минимальные доказательства и понятную связь событий.
Сравните ближайший успешный и неуспешный запрос одного типа в одинаковом контексте. Такая пара часто полезнее большого набора несвязанных ошибок. Но она всё ещё не доказывает причину без механизма. Запишите отличия входов, выбранного обработчика и состояния зависимостей, не добавляя отсутствующие сведения ради красивой временной шкалы.
Сформулировать проверяемую гипотезу
Хорошая гипотеза называет условие, ожидаемый механизм и наблюдение, которое её опровергнет. Например, конкретный общий ресурс исчерпывается в период отказа, что видно в журнале нужного запроса. Если ресурс в норме, а отказ возникает раньше, гипотезу пересматривают. Не превращайте первоначальную догадку из сообщения в обязательный вывод расследования.
Не меняйте сразу несколько несвязанных настроек. После такого пакета временное улучшение не объяснит причину. Выберите минимальную правку или безопасный эксперимент, соответствующий подтверждённому участку. Если для срочного восстановления нужен иной шаг, отделите его от устранения причины в отчёте. Эти состояния имеют разную доказательную силу.
Сохраните отрицательные результаты. Они предотвращают повтор одного и того же эксперимента без новых данных. Но не пишите «проверено всё»: перечисляйте только реальные участки и условия. Если наблюдение неполное, это ограничение, а не доказательство исправности. Такой подход делает расследование продолжимым другим специалистом.
Восстанавливать точечно и наблюдать последствия
Перезапуск может временно вернуть функцию, но одновременно уничтожить часть оперативных признаков. До действия сохраните минимально нужный снимок, если это возможно и не мешает разрешённому восстановлению. Не перезапускайте несвязанные приложения или весь сервер по привычке. Область должна соответствовать найденному процессу и полномочиям.
После восстановления проверьте исходное действие, а не только главную страницу. Если отказ был при записи, нужно разрешённое учебное сохранение с последующим чтением. Если проблема касалась обработки очереди, проверьте движение и хвост. Успешный HTTP-ответ без ожидаемого результата слишком слаб для приёмки бизнес-сценария.
Проверьте накопленные попытки и риск дублей. Возобновившийся обработчик может повторить действия с неизвестным результатом. Используйте существующую модель связи и сверки, не удаляя задания автоматически. Исправление инфраструктурного состояния не даёт разрешения менять клиентскую историю без отдельного согласованного процесса.
Подтвердить устойчивость
Повторите ограниченный набор в тех условиях, где проявлялся отказ, и наблюдайте согласованный период. Одна удачная попытка между двумя ошибками не доказывает устранение. При этом не запускайте бесконечный регресс без причины. Нужен критерий, связанный с частотой исходного симптома и подтверждённым механизмом, а не абстрактное ожидание абсолютного отсутствия любых ошибок.
Сверьте журналы после изменения: исчез ли конкретный подтверждённый отказ, не появилась ли другая ошибка и сохранилась ли правильность данных. Быстрый ответ 404 вместо прежней тяжёлой страницы не является ускорением или восстановлением. Проверяйте статус, содержание и действие вместе. Это защищает от ложного успеха по одному графику.
Если причина не установлена, формулировка результата должна оставаться точной: функция временно восстановлена, наблюдение продолжается, конкретные слои не проверены. Не объявляйте проблему закрытой ради короткого отчёта. Учебная статья может объяснять такой исход без выдуманной победы и без названия клиента.
Подготовить компактную карту инцидента
| Часть | Что фиксировать |
|---|---|
| Событие | Время, действие и фактический статус |
| Шлюз | Наблюдение по нужному запросу |
| Приложение | Первый подтверждённый отказ |
| Зависимость | Категория и совпадающее состояние |
| Изменение | Точная область и основание |
| Проверка | Исходный сценарий и устойчивость |
Соберите для одного учебного запроса временную шкалу с известными событиями шлюза, приложения и зависимости. Отметьте пробелы явно: отсутствие доступа к журналу не превращает предполагаемую ошибку базы в наблюдаемый факт. После получения нужных сведений сопоставьте тот же запрос и период, а не случайную новую ошибку. Так карта инцидента остаётся продолжимой и сохраняет границу между гипотезой и подтверждённой цепочкой.
Готовое расследование связывает запрос, отказ, причину и повторную проверку. Соседство ошибок базы и 502 само по себе такой связи не создаёт. Разделение слоёв помогает выбрать точечное действие и честно показать, что подтверждено, что временно восстановлено и какие вопросы ещё требуют наблюдения.
Связанный разбор: Регламент обновления сайта: кто отвечает за контент, формы, аналитику и безопасность.
Документация и источники
- MDN: 502 Bad Gateway: Значение ответа шлюза и отличие от установленной причины зависимости
- Nginx: HTTP log module: Настраиваемые журналы запросов и контекст конечной обработки